

英国 UKJT は「AI を使わないことも過失になり得る」と整理しました。一方、機密情報の扱いを誤れば義務違反にもなります。本記事では、弁護士が AI を安全に使う4つの運用方法と、情報の機微度に応じた選び方を解説します。
目次
Toggleはじめに
弁護士が AI を業務に利用する動きが広がっています従来、多く語られてきたのは、AI を使ってよいのかという問題でした。しかし、利用が実務に定着するにつれ、議論の焦点も移りつつあります。
2026年7月、英国でひとつの法的声明が公表されました。公表したのは UK Jurisdiction Taskforce(UKJT)です。法曹関係者と技術の専門家で構成される、英国の官民共同組織にあたります。声明は、AI によって生じる損害の責任を整理したものです。
その中で注目されるのが、専門家による AI 利用の位置づけです。もちろん、AI を不適切に利用した場合は責任が問われ得ます。加えて、AI を利用しなかったことも判断材料になり得ると整理されました。つまり基準になるのは、同じ分野の合理的な専門家であれば AI を利用したかどうかです。
もっとも、AI を導入すれば義務を果たせるわけでもありません。UKJT は、利用する専門家が確認すべきポイントも複数挙げています。たとえば、導入前の確認、仕組みの理解、依頼者への説明です。さらに、機密情報の保護、用途への適合性、出力の監督も挙げられています。
そこで実務の課題になるのが、AI をどう業務に組み込むかという設計です。
どの情報を、どのAIに入力するのか。
入力した情報は誰が処理し、どこへ送られるのか。
そして、返ってきた回答をどのように確認するのか。
本記事では、弁護士が AIを利用する際の4つの運用方法と、その選び方を解説します。
一、弁護士のAI利用で問われる「選定・運用・検証」
(一)注意義務の水準は、技術の広がりとともに動く
UKJT の声明が示す視点のひとつは、注意義務の内容が固定されていない点にあります。
判断の基準になるのは、同等の経験や専門性をもつ「合理的な専門家」の行動です。そのため、ある業務で AI の利用が一般化すれば、活用を検討すること自体が通常期待される対応に含まれる可能性があります。また、専門団体のガイダンスや専門家の意見も考慮されます。
もちろん、いま AI を使っていない弁護士が、ただちに義務違反になるわけではありません。むしろ重要なのは、技術や実務慣行の変化に応じて、期待される行動の基準も動くという点です。
(二)英国では監督機関のガイダンスも出ている
実際に、英国の規制機関も具体的な指針を示しています。バリスター(法廷弁護士)の規制機関である Bar Standards Board(BSB)は、2026年5月にAI利用に関するガイダンスを公表しました。特に、BSB が適切な管理を求めているのは次の点です。
- 導入前に、技術のリスク・利益・コストを評価すること
- 基本的な技術理解とAIリテラシーを維持すること
- 情報システムとデータガバナンスを適切に運用すること
- 依頼者への透明性を確保し、機密情報を保護すること
- 依頼者や相手方もAIを利用し得ると認識しておくこと
つまり、AI を適切に使いこなす力そのものが、専門職の職務能力の一部になりつつあります。
(三)注意義務は、機密情報の扱いにも及ぶ
AI のリスクとしては、ハルシネーションによる誤回答が注目されがちです。もっともらしい誤った内容を AI が生成する現象を指します。ただし、専門家が確認すべき範囲は、それだけにとどまりません。
特に重要なのが、機密情報の扱いです。UKJT は、この点について強い表現を用いています。十分な安全性や機密性を備えていない AI に機密情報を入力する行為です。依頼者に対する義務違反となるリスクが極めて高い、と指摘しました。
現在の日本には、UKJT の声明にあたる公的文書は見当たりません。ただし、入力する情報の管理は、すでに既存の法令の対象です。個人情報保護法は、個人データの漏えい・滅失・毀損などを防ぐ「必要かつ適切な措置」を求めています。つまり、海外の議論を待たずとも判断はすでに始まっているといえます。
二、AIのデータの扱いは「学習・保持・送信先」で確認する
AI サービスの説明では、「入力データを学習に利用しません」という記載をよく見かけます。ただし、データ保護を判断するには、もう少し細かく分けて確認する必要があります。
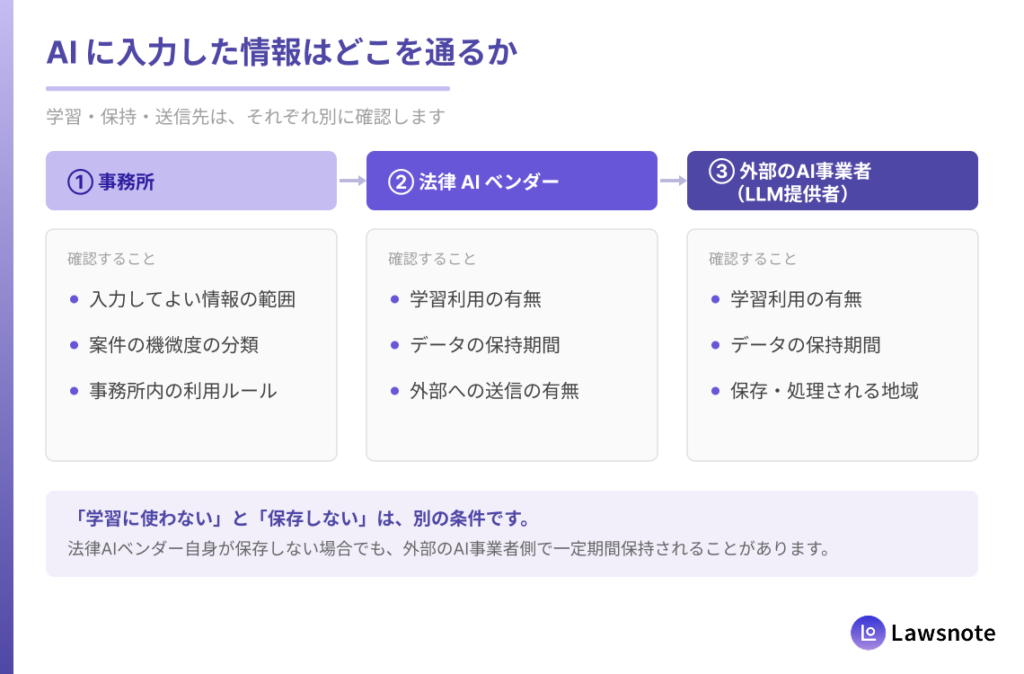
(一)「学習に使わない」と「保存しない」は別の条件
まず区別したいのが、モデル学習とデータ保持です。
「学習に利用しない」とは、入力や回答をモデルの改善や訓練に使わないという意味になります。これに対して「保存しない」は、入力と出力そのものを提供者側に残さない条件を指します。
たとえば OpenAI は、法人向けや開発者向けのサービスについて、入力と出力を原則としてモデル学習に利用しないとしています。一方、保持については別の仕組みです。実際、不正利用の監視を目的として、記録が一定期間(原則30日程度)残る場合があります。そのうえで、条件を満たした組織には、データを保持しない設定を申請する道が用意されています。
したがって、「学習に使われないのだからデータは残らない」という理解は正確とはいえません。
(二)法律AIでは、その先のデータの流れも確認する
法律特化型の AI には、もう一段確認したいポイントがあります。すなわち、そのサービスの裏側でどの AI が動いているかです。
ある法律AI が「入力内容を保存しません」と説明していたとします。ただし、それだけで入力データが一切残らないとは限りません。回答の生成にあたって、外部の AI 事業者(LLM提供者)へデータを送っている場合があるためです。送信先が OpenAI、Anthropic、Google などであれば、次に確認すべきはその送信先の処理条件になります。
実際、ベンダー自身が保存しなくても、送信先で一定期間保持される構成はあり得ます。反対に、送信先との間でデータを保持しない条件を結べば、外部モデルを使いながら保持を抑えることもできます。つまり、確認したいのはサービス名だけではありません。入力した情報が最終的にどこを通るのか、という流れ全体です。
弁護士が AI を比較するときには、次の 5 点を分けて確認すると違いが見えやすくなります。
- 入力と出力がモデル学習に利用されるか
- データは何日間保持されるか
- 自社以外の事業者に送信されるか。送信先はどこか
- 送信先での保持期間と学習利用はどうなっているか
- 再委託先を含む処理条件を、書面で確認できるか
Q. 「学習には利用しません」と書いてあれば、案件資料を入力しても大丈夫ですか?
A. その一文だけでは判断できません。「モデルの学習に利用しないこと」と、「入力したデータを保存しないこと」は別の条件だからです。また、法律AI サービスによっては、回答生成のために第三者の AI 事業者やクラウドサービスへデータを送信する場合があります。案件資料を入力する前に、学習への利用、保存期間、外部への送信先などのデータ処理条件を確認し、情報の機微度に応じて入力範囲を決めることが重要です。
三、弁護士のAI利用で考えられる4つの運用方法
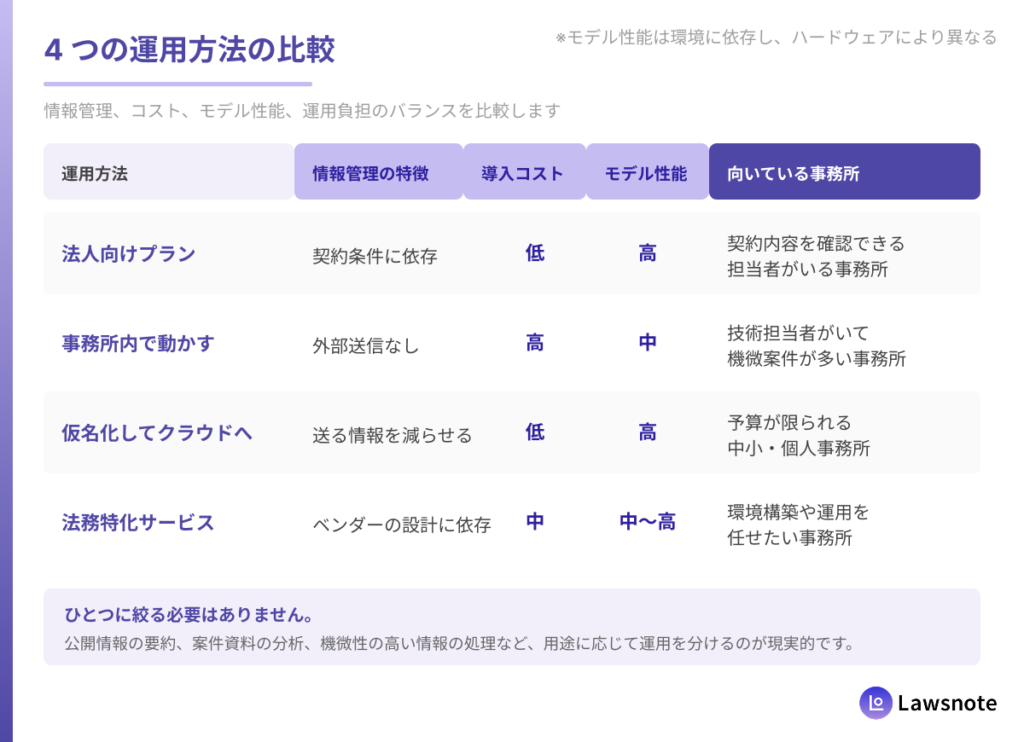
情報管理の観点から見ると、法律事務所での AI 利用はいくつかの型に分けられます。ここでは代表的な4つを整理します。
(一)法人向けプランを利用する
もっとも導入しやすい方法が、生成AI の法人向けプランです。個人向けと比べて、モデル学習への利用制限、管理機能、契約上のデータ保護が用意されています。実際、OpenAI の法人向けサービスでは、入力と出力が初期設定では学習に利用されません。
- メリット:
- 最新の高性能モデルを、比較的簡単に利用できる
- アクセス管理、監査ログ、保持期間の設定など、組織利用向けの機能を使える
- 注意点:
- 管理機能や契約条件はプランごとに異なる
- データを保持しない設定のような高度な制御は、対象が限定される場合がある
サービス名だけで安全性を判断せず、自分の契約プランに適用される条件を確認しておきましょう。そのため、契約内容を確認できる担当者がいる事務所に向いた方法といえます。
(二)事務所内でAIを動かす
外部への送信を極力避けたい場合には、事務所内のパソコンやサーバーでモデルを動かす方法があります。公開されているモデル、いわゆるオープンウェイトモデルを使う運用です。処理を内部で完結させれば、案件データを外部の事業者へ送らずに済みます。
- メリット:
- 外部へのデータ送信そのものをなくせる
- 機微性が特に高い資料でも扱いやすい
- 注意点:
- 一定のハードウェア投資が必要になる
- モデルの更新、アクセス権限、バックアップを自分たちで管理する
なお、事務所内に置けば自動的に安全になるわけでもありません。そのため、技術に詳しい担当者がいて、機微性の高い案件を継続的に扱う事務所に向いています。
(三)仮名化してからクラウドのAIに送る
クラウド型AI の性能を活かしつつ、送る情報そのものを減らす方法もあります。送信前に、氏名、電話番号、住所、口座番号などを事務所側で置き換えます。たとえば「山田太郎」を「関係者A」に変換して送信し、回答を受け取ったあとに元へ戻す、という流れです。
- メリット:
- 既存のクラウド型AI を使いながら、外部へ出す情報を減らせる
- 比較的低コストで始められる
- 注意点:
- 氏名を伏せても、事件の内容や企業名の組み合わせから特定される場合がある
- 情報を削りすぎると文脈が伝わらず、回答の質が下がる
機微度と、AI に必要な文脈量のバランスを取ることが前提になります。特に、予算が限られる中小規模の事務所にとっては現実的な選択肢といえます。
(四)法務特化のサービスを利用する
4つ目は、法律業務向けに設計された AIサービスを利用する方法です。アクセス制御、監査機能、データ管理、法令や判例との連携が組み込まれている場合があります。
- メリット:
- 事務所側でゼロから環境を構築せずに済む
- セキュリティやデータ管理の一部を専門事業者に任せられる
- 注意点:
- 「法務特化」という名称だけでは安全性を判断できない
- 裏側で外部の大規模言語モデルが使われている場合がある
つまり、この方法の価値は任せられる範囲の広さにあります。だからこそ、どの管理策が実際に実装されているかを確認しておきたいところです。
Q. AI の利用方法は、どのような基準で選べばよいですか?
A. 業務の内容や情報の機微度、事務所の IT体制に応じて選ぶことが重要です。ひとつの方法に統一せず、公開情報の要約には法人向けプラン、案件資料には必要に応じて仮名化・マスキングを行い、特に機微性の高い情報は外部 AI に送信しない、といった使い分けが考えられます。
四、弁護士のAI活用は「情報の機微度」と「技術体制」で使い分ける
(一)2つの軸で整理する
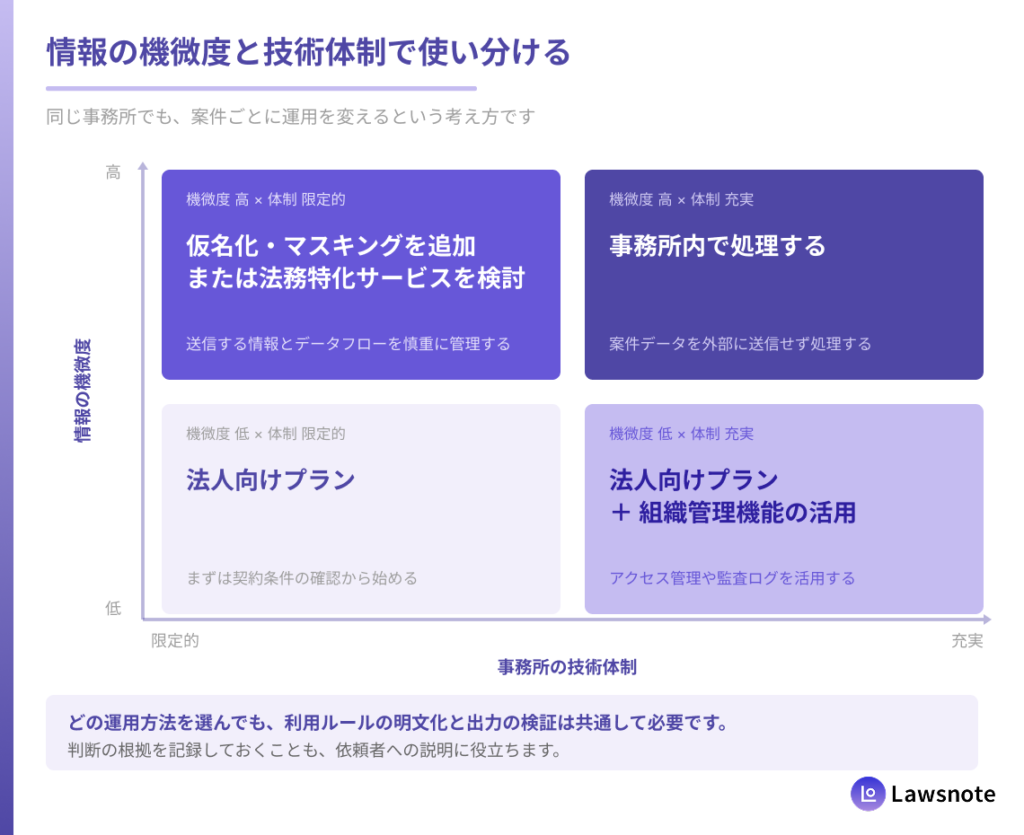
4つのうち、どれを選ぶとよいのでしょうか。ひとつの考え方が、「情報の機微度」と「事務所の技術体制」という2つの軸で整理する方法です。
機微度が比較的低く、技術体制も限られているなら、法人向けのクラウドAI が現実的です。さらに機微度が上がるなら、事前の仮名化を加える方法も考えられます。より高い機密性が求められ、社内に技術体制もあるとします。そのときは、事務所内での処理という選択肢が出てきます。
なお、この2軸で判断できるのは、主に情報をどこまで外部に出せるかです。回答をどこまで実務に使えるかについては、別の軸で考える必要があります。
(二)どの方法でも共通して必要な4つの管理
利用する AI が違っても、共通して必要になる管理があります。
1. 導入前の確認
利用規約、データの処理条件、保持期間、セキュリティ、用途への適合性を確認します。特に外部サービスを使う場合は、再委託先や送信先まで含めて見ることが重要です。
2. 利用ルールの明文化
どの業務でAIを利用できるか。入力してよい情報の範囲はどこまでか。利用を認めるサービスはどれか。
3. 説明と記録
重要な業務で AI を使う場合には、依頼者への説明も想定しておきたいところです。あわせて、なぜそのサービスや処理方法を選んだのかも記録しておくと有効です。
4. 出力の検証
AI が生成した内容は、重要度に応じて確認します。特に判例、法令、引用、事件番号、日付は、誤りが実務上の影響につながります。そのため、こうした情報は一次情報や信頼できるデータベースに戻って確認します。
(三)小規模・個人の事務所が今日からできること
大きな投資をしなくても、AI の利用方法は改善できます。手順は3つです。
まず、現在使っている AIサービスを一覧にします。次に、それぞれについて「学習」「保持」「送信先」を確認します。最後に、公開情報、通常の案件情報、特に機微性の高い情報という3つに分類します。そのうえで、どの AI にどこまで入力してよいかを決めます。
この3つだけでも、状況は大きく変わります。各自の判断で自由に入力する状態から、事務所として管理する状態へ前進できるためです。
五、もう一つの選定軸:AIの回答を検証できるか
(一)安全な環境でも、回答の正確性は別問題
ここまでの4つの方法は、主に入力した情報をどう守るかへの対応です。法律実務には、もうひとつ重要な問題があります。AI が返した回答を、どのように信頼するかです。
高いセキュリティを備えた環境でも、回答の正確性が自動的に保証されるわけではありません。その判例は実在するか。引用した条文は現行法か。つまり法律AI では、情報管理と回答精度を別の軸として考える必要があります。
なお、ハルシネーションが起きる仕組みと、判例を検証する具体的なフローについては、AIハルシネーション時代の判例検索で詳しく解説しています。
(二)リーガルAIの品質は、参照するデータで決まる
ハルシネーションを抑える方法として広く使われているのが、検索拡張生成(RAG)です。AI が外部のデータベースから関連資料を検索し、その資料を参照しながら回答を作ります。ただし、この仕組みを導入しただけで回答が信頼できるようになるわけではありません。参照先に必要な資料がなければ、適切な根拠を取得できないためです。
法令や裁判例は、公的機関のウェブサイトでも公開されています。しかし、集めただけでデータベースになるわけではありません。実際、情報が複数の機関に分散していることもあります。改正・廃止・失効の関係を整理しなければ、ある時点で有効だった内容も判断できません。原資料に誤記や表記のゆれが含まれることもあります。
つまり、リーガルAI に必要なのは資料を大量に集めることだけではありません。収集し、相互の関係を整理し、更新を追跡し、検索できる形で維持する。結果として、このデータ基盤が回答品質の土台になります。
(三)「回答から根拠に戻れるか」を確認する
リーガルAI を選ぶときには、回答精度を示す数値以外にも見るべき点があります。この回答は、どの法律資料を根拠にしているのか。これを確認できるかどうかです。
回答から判例や法令の原文に遡れる仕組みがあれば、利用者自身が判断を検証できます。これは、AI に正解を保証してもらう考え方とは少し違います。弁護士自身が確認するための経路を、AI の側が残しておくという設計です。
Lawsnote は、法律情報データベースを構築してきた経験を基盤にしています。そのうえで、AI が法学資料を検索し、その情報を参照しながら回答する仕組みを開発しています。裁判例や法令を収録するだけでなく、資料の更新や沿革を整理し、検索できる状態を維持すること。これが、回答品質を支える前提だと考えています。
Q. 法務特化の AI なら、判例や条文の正確性は保証されますか?
A. 法務特化AI でも、回答が常に正確とは限りません。参照する法律データの収録範囲や更新状況によっても、回答の質は変わります。選ぶ際は、回答の根拠となる判例や法令が示され、原文まで確認できるかが重要です。
まとめ
弁護士の AI 利用で問われるのは、導入したかどうかではありません。むしろ、どの業務にどの方法で使うかを管理できているかです。本記事の要点を、5つに整理します。
- 「学習に使わない」と「保存しない」は別の条件:どちらか一方の記載だけでは、データ保護の判断はできません
- 確認するのはサービス名ではなくデータの流れ:学習利用、保持期間、送信先、再委託先の4点を書面で確認します
- 運用方法は4つあり、組み合わせが前提:法人向けプラン、事務所内での処理、仮名化+クラウド、法務特化サービスを業務ごとに使い分けます
- 選ぶ軸は「情報の機微度 × 技術体制」:すべてに最高水準を求めるより、案件に応じて変えるほうが現実的です
- 情報管理と回答検証は別の軸:安全な環境でも回答の正確性は保証されないため、根拠に遡れる仕組みかどうかを確認します
どの方法でも共通して必要になるのが、利用ルールの明文化と、判断根拠を説明できる状態づくりです。まずは使っている AI サービスの棚卸しから始めてみてください。
Lawsnote は、法律情報データベースの構築で培ってきた知見を活かしています。そのうえで、法律実務で使える AI とリーガルリサーチの環境を開発しています。サービスや今後の日本向け製品にご関心がありましたら、下記の「お問い合わせ」よりご連絡ください。
郭 栄彦 Barry Kuo
台湾を代表するリーガルテック企業「Lawsnote」の創業者。台湾弁護士・弁理士としての実務経験を経て2016年に同社を設立し、AIを活用したリーガルテック製品の開発・普及を主導。現在はLawsnote Japanの代表として、日本の法律実務の効率化と高度化を支援しています。