

AI判例検索はどこまで実務に使えるのか。OpenAI「Astra for Law」の正答率54.0%が示す可能性と限界、日本で整備が進む民事裁判情報の提供制度との違いを、一次資料に基づいて解説します。
目次
Toggleはじめに
2026 年 9 月 17 日、OpenAI は AI判例検索に対応する「Astra for Law」を発表しました。GPT-6 Astra に専用の法律検索インデックスなどを組み合わせた、法律業務向けの AI 基盤です。OpenAI のベンチマークでは、総合正答基準の通過率は 54.0% でした。ウェブ検索のみの GPT-6 Astra は 38.7% です。なお、これは OpenAI 自身による評価で、独立した第三者検証ではありません。
ただし、検索対象は現時点では米国法です。日本法への対応は発表されていません。そのため、日本の弁護士の実務が直ちに変わるわけではありません。
一方、この結果は日本のリーガルテックにとっても重要です。専用インデックスを備えた構成が、ウェブ検索のみの場合を上回ったからです。
本記事では、54.0% という数字の意味と限界を整理します。さらに、日本の民事裁判データ基盤の整備状況を確認します。
一、Astra for Law とは何か
(一)検索対象は米国法、日本法対応は未発表
Astra for Law の法律検索インデックスは、米国の判例法、制定法、規制、裁判所規則、行政決定を対象としています。OpenAI の公式発表では、検索対象を次のように説明しています。
U.S. case law, statutes, regulations, court rules, and administrative decisions
現時点で、米国以外の法域は明示されておらず、日本法への対応も発表されていません。したがって、少なくとも専用インデックスによる日本法の判例検索は、現時点では提供されていません。日本の実務への影響を考える際は、まずこの対象範囲を押さえる必要があります。
(二)2 億 3,000 万 URL を収録する法律検索インデックス
Astra for Law は、GPT-6 Astra に法律検索インデックス、専用の設定や指示を組み合わせた AI 基盤です。大きな特徴となる法律検索インデックスは、2 億 3,000 万件を超える URL を検索対象とし、新しい情報源も毎日追加されます。
このインデックスには、非営利団体 Free Law Project が運営する CourtListener の判例データも組み込まれています。OpenAI の公式発表では、CourtListener の判例コレクションが「公表された米国の先例的判例法の 99.9%以上」をカバーすると説明されています。ただし、これは OpenAI 側の説明である点に留意が必要です。
提供は段階的に始まります。当初は、米国の選定された法律事務所を対象に、ChatGPT および Codex の Trusted Access を通じて提供されます。API については、「gpt-6-astra-law」というモデル名で提供される予定です。
(三)総合正答基準の通過率は 54.0%
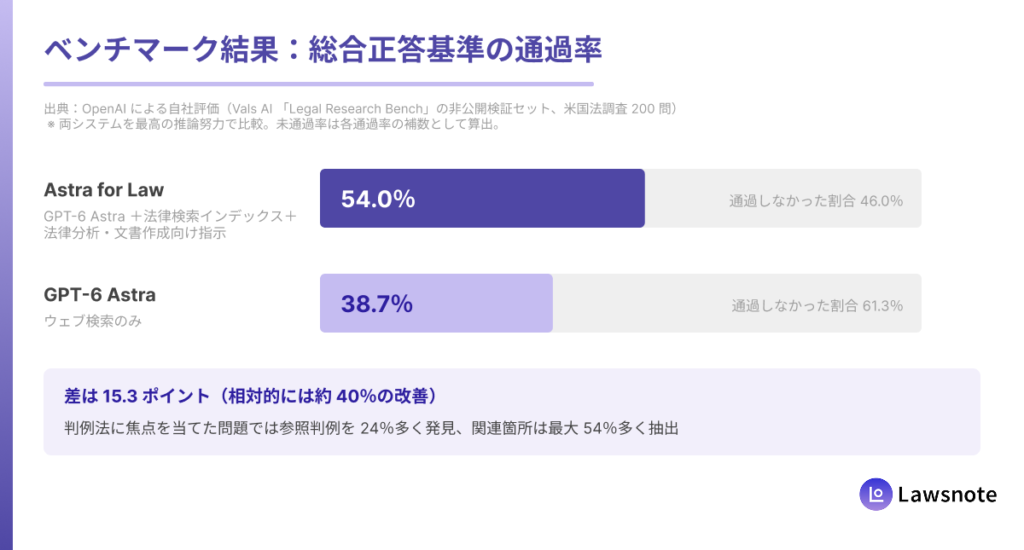
OpenAI は、Vals AI の「Legal Research Bench」の非公開検証セットから抽出した、米国法に関する法律調査問題 200 問を使って評価しました。両システムを最高の推論強度で比較した結果、Astra for Law が総合正答基準を通過した割合は 54.0% でした。一方、ウェブ検索のみを使用した GPT-6 Astra は 38.7%です。差は 15.3 ポイントで、相対的には約 40%の改善にあたります。
さらに、判例法に焦点を当てた問題では、Astra for Law が参照判例を 24%多く発見しました。また、監査対象となった目標箇所については、正しい裁判例から関連箇所を 最大 54%多く抽出しています。
ただし、このベンチマークは OpenAI 自身が実施したものです。独立した第三者による検証ではありません。
二、AI 判例検索の正答率 54.0%をどう読むか
(一)専用データ基盤の有無で 15.3 ポイントの差
Astra for Law の通過率は 54.0%、ウェブ検索のみを使用した GPT-6 Astra は 38.7%でした。両者の差は 15.3 ポイントです。
ただし、この差をすべて法律検索インデックスの効果と捉えることはできません。今回比較されたのは、法律検索インデックスや専用の指示・設定を組み合わせた Astra for Law の完全な構成と、ウェブ検索のみを使用した GPT-6 Astra です。したがって、ベンチマークが示しているのは、法律業務向けに調整された構成全体の効果です。
Business Insider の報道によると、OpenAI の技術スタッフである Sherwin Wu 氏は、「モデルを実際の判例法に根拠づけることで、ハルシネーションが減り、法的推論がより堅実になった」と説明しています。
ここで注目したいのは、汎用 AI を開発する企業自身が、法律業務向けの専用構成とウェブ検索のみの構成との差を数値で示したことです。リーガル AI と汎用 AI の違いは、以前から指摘されてきました。今回の発表では、その差が具体的な数字として示されました。
(二)46.0%は総合正答基準を通過していない
もっとも、通過率は 54.0%にとどまります。専用インデックスを積み、最大の推論努力で動かした場合の数字です。言い換えれば、残る 46.0%は総合正答基準を通過していません。
ただし、この 46.0%は「判例を取りこぼした割合」ではありません。また、「回答がすべて誤っていた割合」でもありません。正確には、評価の総合正答基準を通過しなかった問題の割合です。
この水準をどう評価するかは、読む側の判断に委ねられます。ただし、実務上の含意は一つに絞られます。AI 判例検索の出力を、そのまま使える段階ではありません。実務では、根拠となる裁判例や引用箇所を確認する工程が必要です。この点は「AI ハルシネーション時代の判例検索」でも詳しく扱っています。
(三)ベンチマークの測定範囲を 5 つの軸で整理する
1.法務における AI 関与の 5 つの軸
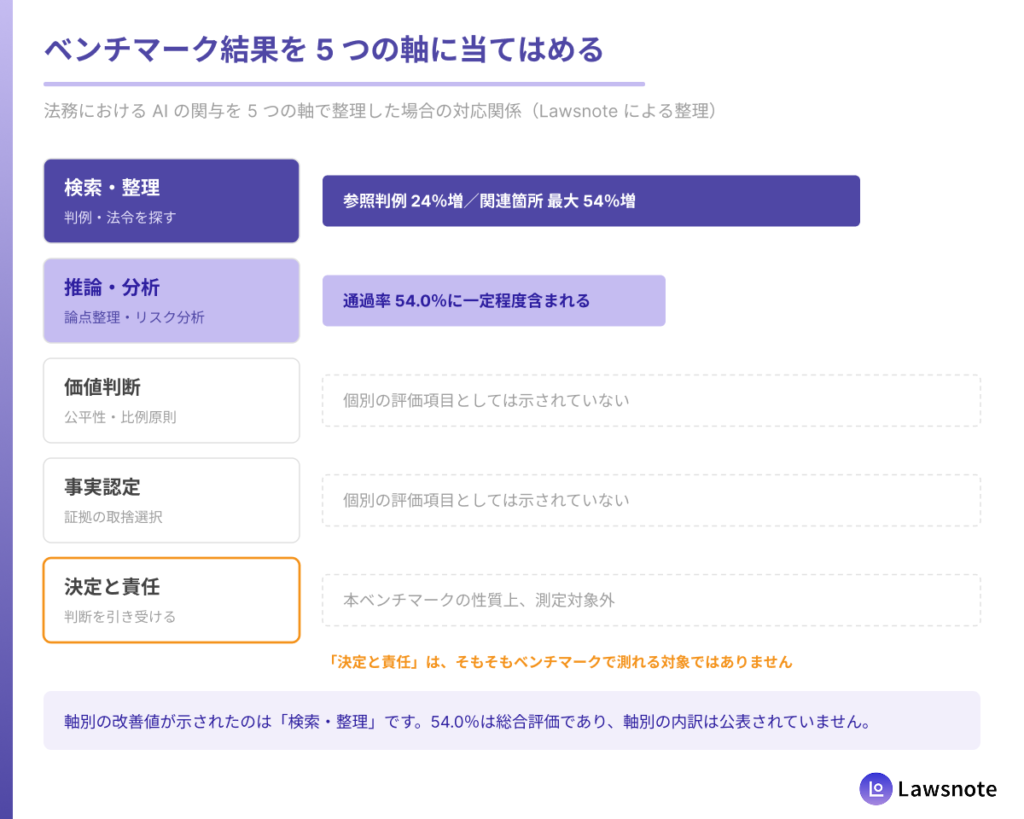
Lawsnote では、法務における AI の関与を 5 つの軸に分けて整理しています。具体的には、検索・整理、推論・分析、価値判断、事実認定、決定と責任の 5 つです。この枠組みは「AIは弁護士を代替するのか?生成AI時代の法務と「判断」の境界線」でも使用しており、各軸の詳細はそちらで解説しています。 この 5 つの軸に今回のベンチマークを当てはめると、次のように整理できます。| 軸 | 内容 | このベンチマークとの関係 |
|---|---|---|
| 検索・整理 | 判例や法令を探し、関連箇所を取り出す |
具体的な数値あり 参照判例 24%増/関連箇所 最大 54%増 |
| 推論・分析 | 論点整理、リスク分析、シナリオ比較 |
評価に含まれる 総合正答基準の評価に一定程度含まれていると考えられる |
| 価値判断 | 公平性、社会通念、比例原則を前提とした判断 |
個別の数値なし 個別の評価項目としては示されていない |
| 事実認定 | 証拠の取捨選択、信用性の評価、整合的な事実関係の構築 |
個別の数値なし 個別の評価項目としては示されていない |
| 決定と責任 | 判断を引き受ける主体になること |
測定対象外 このベンチマークの測定対象ではない |
5 つの軸とベンチマークの対応関係は Lawsnote による整理です。OpenAI が軸ごとの評価結果を公表しているわけではありません。
2.具体的な数値が示されたのは「検索・整理」
つまり、このベンチマークが明確に数値を示したのは「検索・整理」の軸です。参照判例の発見数と、関連箇所の抽出数について、それぞれ改善幅が公表されています。
また、総合正答基準の通過率には、検索結果を使って回答を組み立てる「推論・分析」も一定程度含まれていると考えられます。一方、残る 3 軸は、個別の評価結果が示されていません。
したがって、仮に通過率が 54.0%から 80%に上昇しても、それだけで法律調査や法律実務の全体が完結に近づいたとはいえません。測定された範囲での性能向上と、ベンチマークが対象とする範囲は、分けて考える必要があります。
なお、5 つの軸とベンチマークの対応関係は、Lawsnote による整理です。OpenAI が軸ごとの評価結果を公表しているわけではありません。
Q. 通過率 54.0%は、実務で使うには低い数字でしょうか。
A. この数字だけで、一概に高い、低いと判断することはできません。54.0%は、OpenAI が選定した米国法の調査問題 200 問における通過率であり、法律実務全体の正答率ではないためです。また、この結果は、判例の発見や関連箇所の抽出といった補助的な利用を否定するものではありません。重要なのは、出典を確認できることと、出力を検証する体制が整っていることです。そのうえで、利用の可否を業務ごとに判断する必要があります。
三、AI 判例検索を支える公開判例データ
(一)CourtListener が提供する米国判例データ
Astra for Law の法律検索インデックスには、CourtListener の判例コレクションが組み込まれています。CourtListener は、非営利団体 Free Law Project が運営する、一般公開の米国裁判データベースです。判例に加え、口頭弁論、裁判官、連邦裁判所の事件記録なども収録しています。
CourtListener のデータは、Astra for Law が利用する複数の情報源の一つです。そのため、CourtListener の存在だけで、2 億 3,000 万 URL を超える法律検索インデックス全体が構築されたと捉えることはできません。一方、すでに整備されていた判例コレクションが、AI 判例検索の基盤に組み込まれている点は重要です。
AI 判例検索の性能には、モデルに加えて、検索対象となるデータの範囲、品質、更新頻度も関わります。この構造については「【実務解説】弁護士が知っておきたい:判例検索エンジンの仕組み」でも解説しています。また、CourtListener の収録範囲は民事事件に限定されておらず、刑事事件の裁判例も含まれます。この違いは、後述する日本の制度との比較で改めて確認します。
(二)公開判例データと商用 AI 基盤は別のもの
CourtListener と Astra for Law は、役割が異なります。CourtListener は、一般に公開され、ウェブ上で判例を検索できるデータベースです。一方、Astra for Law は、複数の情報源、専用の法律検索インデックス、GPT-6 Astra、法律分析用の指示や設定を組み合わせた AI 基盤です。
そのため、基礎となる判例データが無償で公開されていることと、そのデータを利用する AI 基盤の提供条件は分けて考える必要があります。Astra for Law の利用対象や提供方法は、OpenAI が別途定めています。
また、OpenAI は、Harvey や Legora などの API 顧客が、Astra for Law を自社製品や業務フローに組み込めるようになると説明しています。このように、判例データ、専用インデックス、AI モデルを組み合わせる仕組みは、法律事務所向けのサービスに加え、リーガルテック企業の製品にも広がりつつあります。
四、日本の民事裁判データ基盤はどう整備されるのか
(一)「民事裁判情報の活用の促進に関する法律」とは
日本でも、判例データの提供基盤を整える動きが進んでいます。その中心にあるのが、「民事裁判情報の活用の促進に関する法律」です。
制度の流れは、主に 3 段階で構成されています。まず、最高裁判所が民事裁判情報を指定法人に提供します。次に、指定法人が氏名などの情報を削除または置換し、仮名加工民事裁判情報を作成します。仮名加工とは、他の情報と照合しない限り、特定の個人を識別できない状態にする処理です(法第 2 条第 1 項第 3 号、法第 13 条)。
その後、指定法人は利用者と情報提供契約を締結し、仮名加工後の情報を電磁的方法で提供します。提供は有償で行われ、利用料金によってデータベースの整備や運営に必要な費用を賄う仕組みです。
施行は段階的に進められています。2026 年 1 月 15 日には、基本方針の策定や指定法人の指定などに関する規定が施行されました。同日、施行規則(令和 8 年法務省令第 1 号)が公布され、基本方針も告示されています。
(二)対象は民事訴訟と行政事件訴訟
法第 2 条第 1 項第 1 号は、対象となる民事裁判情報を次のように定めています。
民事訴訟手続及び行政事件訴訟手続において作成された電磁的記録に記録された情報
対象となる記録は、次の 3 種類です。
- 電子判決書:民訴法第 252 条第 1 項に規定するもの
- 電子調書:民訴法第 254 条第 2 項に規定する調書判決に係るもの
- 電子決定書:民訴法第 122 条で準用する第 252 条第 1 項に基づくもののうち、法務省令で定めるもの
一方、人事訴訟を含む家事事件は、現行制度の対象に含まれません。また、非訟事件、民事執行事件、倒産手続、刑事事件も対象外です。
前述のとおり、CourtListener の収録範囲には刑事事件も含まれます。米国の CourtListener と日本の新制度では、対象とする裁判手続の範囲が異なります。
(三)電子化後の裁判書から蓄積する
対象となる電子判決書などには、次の限定があります。
裁判所の使用に係る電子計算機に備えられたファイルに記録されたもの
そのため、紙で作成された過去の判決書は、制度の対象になりません。電子判決書は、民事訴訟手続のデジタル化(2026 年 5 月 21 日)から全面適用されています。つまり、本法による提供基盤は、対象となる電子裁判書から順次積み上がります。
Q. 日本でも Astra for Law のような AI 判例検索はすぐに実現しますか。
A. 制度としては、2027 年 5 月ごろの施行が見込まれています。ただし、データ提供の開始日、形式、料金、契約条件は確定していません。また、提供開始後も、各事業者によるデータの取得、整理、検索システムへの実装が必要です。まずは施行日と提供条件の公表を確認し、その後に実務への影響を検討する必要があります。
五、米国の公開判例データと日本の新制度を比較する
(一)比較の前に区別したい 3 つの仕組み
| 比較項目 | CourtListener を中心とする 米国の公開裁判データ |
日本の指定法人制度 |
|---|---|---|
| 位置付け | 一般向けの法律調査サイト・裁判データ基盤 | 法律に基づく民事裁判情報の加工・提供制度 |
| 担い手 | 非営利団体(Free Law Project) | 法律に基づく指定法人 1 法人(日弁連法務研究財団) |
| 費用 | 一般向けの判例検索・閲覧は無料。API や大量データの利用条件は別途設定 | 仮名加工した情報を有償で提供。具体的な料金は未公表 |
| 対象範囲 | 連邦・州・専門裁判所の判例を収録。民事事件と刑事事件を含む | 民事訴訟・行政事件訴訟の電子判決書、電子調書、一定の電子決定書 |
| 蓄積 | 過去の判例を含む大規模なコレクションを整備し、継続的に更新 | これから 2027 年 5 月ごろの全面施行後、対象となる電子裁判書から順次蓄積 |
| 提供形式 | ウェブ検索、REST API、バルクデータ、データベース複製など | 未確定 電磁的方法で提供。API も想定されるが、具体的な形式は未確定 |
| 利用者 | 一般の利用者が検索可能。API などはアカウント、会員区分、利用条件の適用あり | 特定の業種に限定されず、個人も制度上は利用可能。情報提供契約と料金の支払いが必要 |
橙色の項目は、日本側で内容がまだ確定していないものです。施行日や提供条件は、今後の公表を確認する必要があります。
(二)担い手・費用・対象範囲が異なる
このように、CourtListener と日本の指定法人制度では、位置付け、担い手、費用、対象範囲が異なります。
Astra for Law の法律検索インデックスには、CourtListener の判例コレクションが組み込まれています。ただし、2 億 3,000 万 URL を超える法律検索インデックスは、判例、制定法、規制、裁判所規則、行政決定など、複数の情報源から構成されています。そのため、CourtListener の存在だけで巨大なインデックスが構築されたと評価することはできません。
一方、米国では、すでに蓄積された公開判例コレクションが、AI 判例検索に利用されています。日本でも、指定法人の決定や施行規則の整備まで進んでいます。
したがって、米国と同じ形の AI 判例検索が、日本ですぐに実現するとは限りません。日本における AI 判例検索の水準には、モデルの性能に加えて、データの収録範囲、品質、更新頻度、提供形式、利用条件が関わります。また、出典を確認できる設計や、回答を検証する仕組みも重要です。
特に、日本の新制度は、民事訴訟と行政事件訴訟の電子裁判書などからデータを蓄積します。刑事事件や過去の紙媒体の判決書が対象外である点も、今後の AI 判例検索サービスを評価するうえで確認しておく必要があります。
六、AI 判例検索ツールを選ぶ際の 3 つのポイント
データ基盤は、AI 判例検索ツールの性能を左右する重要な条件の一つです。ツールを選ぶ際は、モデル名に加えて、そのモデルが参照する判例データも確認する必要があります。特に確認したいのは、次の 3 点です。
(一)判例データはどこから来ているか
まず確認したいのは、判例データの出どころです。自社で構築したデータベースを利用しているのか、他社から提供を受けているのか、公開情報を収集・索引化しているのかを確認します。データの取得方法によって、収録範囲、更新の確実性、原文まで遡れるかどうかが変わります。
日本では、本法の運用が始まると新たな区別が生じる可能性があります。「一次利用者か二次利用者か」という区別です。データの出どころは、今後さらに重要な判断材料になると考えられます。
(二)収録範囲と更新頻度は明確か
次に確認したいのは、収録範囲と更新頻度です。対象となる裁判所、審級、事件類型、収録年代を確認します。また、判決だけでなく、決定や命令も収録しているかという点も重要です。
更新頻度も同様です。更新の間隔は、調査結果の鮮度に直結します。Astra for Law も、情報源の毎日追加を明示していました。
(三)原文とその後の裁判経過を確認できるか
最後に確認したいのは、出力を検証しやすい設計になっているかという点です。具体的には、回答から原文の裁判書まで遡れるかを確認します。さらに、その後の裁判経過まで確認できるかどうかも欠かせません。上訴、取消し、変更、上級審の判断などです。ここは AI 判例検索を選ぶうえで、最も実務的な分岐点になります。
なお、監督の方法にも選択肢があります。出力を一件ずつ確認せず、方針と基準を設定して監督・承認する考え方です。この点は「【AI時代の法務戦略】エージェント型AIが変える法律実務」で扱っています。
まとめ:AI 判例検索はデータと検証体制で選ぶ
Astra for Law が示したのは、2 つの事実です。1 つは、専用のデータ基盤を備えた AI 判例検索が汎用ウェブ検索を上回ること。総合正答基準の通過率で、54.0%と 38.7%という差が出ました。もう 1 つは、46.0%が通過基準に届いていないことです。検証工程は省略できません。
一方、日本では提供基盤そのものが制度として設計途上にあります。全面施行は 2027 年 5 月ごろと見込まれています。ただし、対象範囲も費用も提供形式も、米国の状況とは異なります。
これからの判例検索では、「そのデータはどこから来ているか」を確認する視点が欠かせません。AI 判例検索の精度には、モデルの性能、データの収録範囲と品質、更新頻度、出典表示、検証方法が関わります。
関連記事
郭 栄彦 Barry Kuo
台湾を代表するリーガルテック企業「Lawsnote」の創業者。台湾弁護士・弁理士としての実務経験を経て2016年に同社を設立し、AIを活用したリーガルテック製品の開発・普及を主導。現在はLawsnote Japanの代表として、日本の法律実務の効率化と高度化を支援しています。
Lawsnote は、法律情報データベースの構築で培ってきた知見を活かし、法律実務で使える AI とリーガルリサーチの環境を開発しています。
その取り組みの一つとして、事件番号の表記ゆれを統一する無料ツールを公開しています。判決文やメモを貼り付けると、文章に含まれる事件番号だけを抽出し、統一形式へ変換します。複数の事件番号も一括で処理でき、登録やログインは必要ありません。
判例検索や書面の作成では、事件番号の表記が揃っていないと、確認や引用に手間がかかります。まずは「事件番号表記変換ツール」からお試しください。
サービスや今後の日本向け製品にご関心がありましたら、下記の「お問い合わせ」よりご連絡ください。